#网站发布

目标

把 Obsidian 库里的一部分笔记,作为 Hexo 网站文章的原始文件,实现「在 Obsidian 里写,一键同步到网站」。

核心原则:单向同步,Obsidian 是唯一事实源

这套方案是单向的,不是双向的。Obsidian 是唯一事实源(single source of truth),Hexo 的 source/_posts 是生成产物。

这个原则不可动摇,原因是:

  • 两边都允许改,最后一定会冲突。同一篇文章在两处各自演化,没有可靠的自动合并办法,最终必然出现内容分歧、难以判断哪个才是正确版本。
  • 在网站仓库里直接改的文章,下次同步会被 Obsidian 版本覆盖。因为脚本的每一次运行都以 Obsidian 笔记为准重新生成目标文件,Hexo 侧的手动修改不会被保留,也不会回流。

因此实际操作上必须遵守:

  • 改内容,只改 Obsidian 笔记,改完重新跑同步脚本
  • Hexo 的 source/_posts 视为只读产物,不要直接在里面编辑文章;如果要改某篇网站文章,回到对应的 Obsidian 笔记改,再同步
  • 如果哪天确实需要在网站上做临时修改,也要想清楚它会在下次同步时丢失

脚本本身也按这个原则设计:状态文件 .sync_state.json 只记录「哪篇文章由哪篇笔记生成」,用于判断更新;从不做 Hexo → Obsidian 的反向写入。

为什么不能直接软链接

两边的 Markdown 并不兼容:

维度 Obsidian Hexo 要求
元数据 大多没有,或不规范 必须有 YAML front-matter(title/date/tags/categories)
内部链接 双方括号 wiki 语法 标准 Markdown 链接语法
图片 感叹号 + 双方括号嵌入 标准图片语法 + 图片放进 source
文件名 中文 英文 slug(影响 URL)

所以中间必须有一层「转换」,这就是同步脚本干的事。

实现方式

架构是一条单向流水线:

1
2
3
4
5
6
7
Obsidian 笔记(打 #网站发布 标签)
↓
同步脚本 obsidian_to_hexo.py(v2)
↓ 生成 front-matter / 转换链接和图片 / 写入
Hexo source/_posts/*.md
↓ hexo g -d
GitHub Pages 上线

脚本(private_hexo/tools/obsidian_to_hexo.py,Python3 零依赖)做五件事:

  1. 筛选:默认只扫描库里的 Projects/影响力/网站文章 目录(可用 --source-dir 改),命中规则是「文件名带 [网站] / [网址] 前缀」或「打了 #网站发布 标签」
  2. 生成元数据:从 front-matter 读 title/date/categories/tags,缺的用文件名、文件修改时间、默认值补齐;复用已存在文章的文件名做 slug,避免 URL 变更
  3. 转换正文:去掉注释标记和块引用 id,wiki 双链降级为纯文本
  4. 搬运图片:把 Obsidian 的图片嵌入找出原图复制到 Hexo 的 source/downloads/images/obsidian,并改写为标准图片路径(按内容哈希命名,避免冲突)
  5. 记录状态:用 .sync_state.json 记住「哪篇文章由哪篇笔记生成」,后续只更新变化的,源笔记不再命中时网站文章保留不动(只报告不删除)

设计上默认 dry-run:不加 --apply 只预览不写文件,安全优先。已存在但未被纳管的同名文章默认跳过,需 --adopt 才接管,避免误覆盖。

怎么使用

第一步:标记要发布的笔记

在 Obsidian 笔记里任意位置写一行:

1
#网站发布

(本文就是打了这个标签的 demo,已成功同步为网站文章)

第二步:运行脚本

在 private_hexo 目录下:

1
2
3
4
5
# 预览:看看会同步哪些笔记、生成什么文件名
python3 tools/obsidian_to_hexo.py

# 确认无误后,实际写入
python3 tools/obsidian_to_hexo.py --apply

常用参数

参数 作用
--source-dir 目录 只扫描库里这些目录,可重复传(默认「Projects / 影响力 / 网站文章」)
--prefix 前缀 文件名含该前缀才同步,可重复(默认 [网站]、[网址])
--tag 标签名 换发布标签,默认 网站发布
--exclude-dir 目录 / --exclude-name 名称 排除目录或文件名关键词
--adopt 接管已存在但内容不同的同名文章(覆盖)
--no-update 不更新已纳管的文章
--keep-wikilink / --keep-boilerplate 保留双链原样 / 保留样板提示行
--images-dir / --state 自定义图片目录和状态文件路径

如果只想靠标签筛选、不希望文件名前缀规则生效(例如做单篇测试),可以传一个不会匹配任何文件的前缀:

1
python3 tools/obsidian_to_hexo.py --prefix "__nomatch__" --apply

这里的 __nomatch__ 只是一个占位值,作用是把默认的前缀规则「架空」,从而只保留 #网站发布 标签筛选。

第三步:部署上线

脚本只写文件,不会自动部署。生成完成后:

1
hexo clean && hexo g -d

当前限制

  • 单向(设计如此):只做 Obsidian → Hexo,网站上的改动不回流、会在下次同步时被覆盖。详见上文「核心原则」。
  • 图片依赖原始文件存在:图片嵌入若库里找不到同名原图,会退化成占位路径并给出警告,需手动补图
  • 标签语法:示例里的 wiki 图片 / 双链写法若出现在正文,会被脚本当真实引用处理,写示例时注意用文字描述

相关文件

  • 脚本:hexo_dir/tools/obsidian_to_hexo.py
  • 说明:hexo_dir/tools/README-obsidian-sync.md

我长期持有 [[红利低波]],作为投资的压舱石,偶然的机会了解到 红利打新策略 – “将持有的红利指数基金换成相应的成分股,然后通过打新获得额外的打新收益,预计未来每年能获得 3-5% 打新收益率,另外直接持有股票可以节省基金的管理费、托管费、交易费、财务法律费用”,这个思路启发我深度研究下这个是否可行。

我在研究过程中,偶然发现另一个差异点,那就是 “个人直接持股分红” 和 “通过间接持股购买红利低波 ETF” 的税收。

我并非科班出身的法律或投资专家,视角或许不够全面客观。我始终坚持一个原则:引用的每一组数据、每一份材料都必须有处可查,绝不凭空捏造。如果您发现任何差错,欢迎随时指正,您的批评是我学习进步的最大动力。

个人直接持股

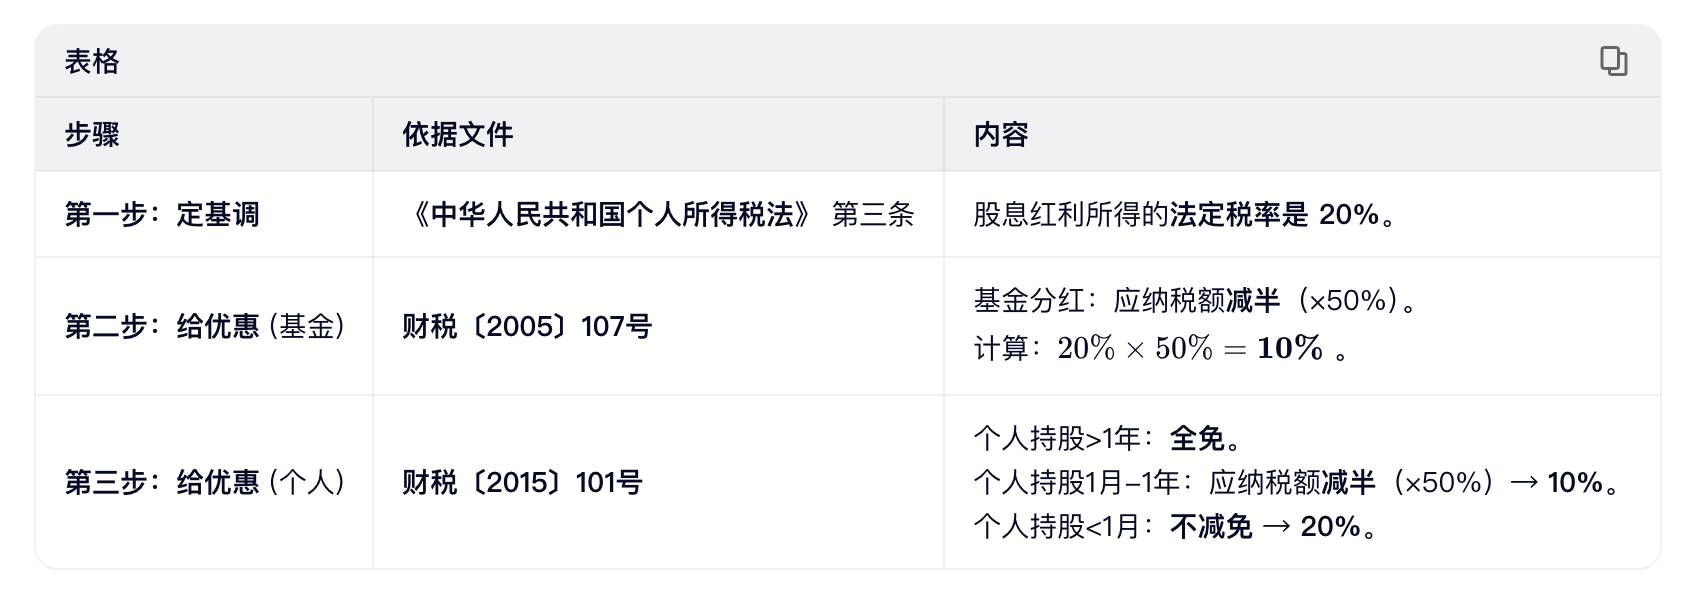
  • 根据 财税〔2015〕101 号:“个人从公开发行和转让市场取得的上市公司股票,持股期限超过 1 年的,股息红利所得暂免征收个人所得税。”
  • 实际操作中,在收到分红时,通常先全额到账(具体看券商系统,我的券商是全款到账),但在卖出股票时,系统会根据您的持有时间自动计算并补扣税款。如果持有超过 1 年,则完全不用交税。

购买红利低波 ETF(通过基金间接持股)

税率固定:上市公司向基金派发股息时,统一按 10% 的税率代扣代缴个人所得税(无论基金持有了多久),数据来源在下面有引用。

  • 中华人民共和国个人所得税法:特许权使用费所得,利息、股息、红利所得,财产租赁所得,财产转让所得,偶然所得和其他所得,适用比例税率,税率为百分之二十。
  • 财税 [2005] 107 号:对证券投资基金从上市公司分配取得的股息红利所得,按照财税 [2005] 102 号文规定,扣缴义务人在代扣代缴个人所得税时,减按 50%计算应纳税所得额。

根据上面两个条款内容:个人所得税 = 分红金额 ×50% (减半)×20% (个税法法定税率)= 分红金额 ×10% 。

总结一下

红利纳税比较

  • 中华人民共和国个人所得税法:特许权使用费所得,利息、股息、红利所得,财产租赁所得,财产转让所得,偶然所得和其他所得,适用比例税率,税率为百分之二十。
  • 财税 [2005] 107 号:对证券投资基金从上市公司分配取得的股息红利所得,按照财税 [2005] 102 号文规定,扣缴义务人在代扣代缴个人所得税时,减按 50%计算应纳税所得额。
  • 财税〔2015〕101 号:“个人从公开发行和转让市场取得的上市公司股票,持股期限超过 1 年的,股息红利所得暂免征收个人所得税。”

对于超长期持有者,直接持股更划算;对于中短期或频繁调仓者,ETF 更划算或持平。

对我而言,我是长期持有策略,那么单从 税率 这部分考虑,个人直接持股 更适合我。

代价是什么呢?

已知个人持有的风险有:

  • 红利低波 ETF 会不断调整成分股(卖出旧股,买入新股)。每次跟着调仓卖出股票 (费心),如果某股票分红不久后就卖出,可能触发高额税负,但是 “持有 1 个月后是 10%”,和 ETF 持平。
  • 欢迎各位评论区补充。

什么是 Rag?

检索增强生成(Retrieval-augmented Generation),简称 RAG。

简单来讲,RAG 就是通过检索获取相关的知识并将其融入 Prompt,让大模型能够参考相应的知识从而给出合理回答。

因此,可以将 RAG 的核心理解为 “检索 + 生成”,前者主要是利用 [[向量数据库]] 的高效存储和检索能力,召回目标知识;后者则是利用大模型和 Prompt 工程,将召回的知识合理利用,生成目标答案。

RAG 架构

完整的 RAG 应用流程主要包含两个阶段:

  • 数据准备阶段:数据提取 ——> 文本分割 ——> 向量化(embedding)——> 数据入库。
  • 应用阶段:用户提问 ——> 数据检索(召回)——> 注入 Prompt ——> LLM 生成答案。

向量化(embedding)

向量化是一个将文本数据转化为向量矩阵的过程,该过程会直接影响到后续检索的效果。

数据检索

常见的数据检索方法包括:相似性检索、全文检索等,根据检索效果,一般可以选择多种检索方式融合,提升召回率。

  • 相似性检索:即计算查询向量与所有存储向量的相似性得分,返回得分高的记录。常见的相似性计算方法包括:余弦相似性、欧氏距离、曼哈顿距离等。

注入 Prompt

Prompt 作为大模型的直接输入,是影响模型输出准确率的关键因素之一。在 RAG 场景中,Prompt 一般包括任务描述、背景知识(检索得到)、任务指令(一般是用户提问)等。

1
2
3
4
5
6
【任务描述】
假如你是一个专业的客服机器人,请参考【背景知识】,回
【背景知识】
{content} // 数据检索得到的相关文本
【问题】
石头扫地机器人P10的续航时间是多久?

参考文献

钩子函数(HOOK)vs 回调函数(CALLBACK)

回调函数是开发者通过参数,传递给另一个函数的函数,允许程序在完成特定操作后执行预定的函数。它是一种实现异步编程和事件驱动编程的技术。

临时变量的生命周期

C++ 中的临时变量指的是那些由编译器根据需要在栈上产生的,没有名字的变量。其主要的用途主要有两类:

  • 函数的返回值
  • 类型转换时的中间变量

一般来说,C++ 中的临时变量在表达式结束之后 (full expression) 就被会销毁 / The temporary will be destroyed after the full expression.

The lifetime of the temporary bound to a const reference extends till the lifetime of const.

Demo

Segmentation_fault_demo++view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
#include <iostream>
#include <unordered_set>
#include <vector>

class A {
public:
A(const std::unordered_set<int>& const_v_in, std::unordered_set<int> v_in)
: const_set_values_(const_v_in), set_values_(v_in) {}

bool has_const_value(int ix) const {
return const_set_values_.find(ix) == const_set_values_.end();
}

bool has_value(int ix) const {
return set_values_.find(ix) == set_values_.end();
}

private:
const std::unordered_set<int>& const_set_values_;
std::unordered_set<int> set_values_;
};

int main() {
A a({0}, {0});

std::cout << " whether A instance has value " << a.has_value(0)
<< std::endl;
std::cout << " whether A instance has const value " << a.has_const_value(0)
<< std::endl;

return 0;
}

源码

源码下载

源码下载

编译

1
2
cd 文件下载目录
g++ oom_reference.cpp -o test --std=c++14

注意:因为编译器优化等原因 (我的版本是 g++ 7.5),你在本地验证时不一定会崩溃,但是这即使不崩溃,也是一个 undefined bahvior 问题,不安全。

1
2
// 查看 g++ 版本
g++ --version

One more thing

编程实践

// When one stores the reference one should also forbid rvalues: A(const std::unordered_set&&)=delete;

禁止移动构造_demo++view raw
1
A(const std::unordered_set<int>&&) = delete;

参考链接

Package

  • You can add an optional package specifier to a .proto file to prevent name clashes between protocol message types.
  • In C++ the generated classes are wrapped inside a C++ namespace.
    • 即 package 指定的路径,会被转换为 namespace,来避免命名冲突。

Arena Allocation

  • 功能:Arena allocation is a C+±only feature that helps you optimize your memory usage and improve performance when working with protocol buffers.
  • 原因:By default, protocol buffers performs heap allocations for each message object, each of its subobjects, and several field types, such as strings. These allocations occur in bulk when parsing a message and when building new messages in memory, and associated deallocations happen when messages and their subobject trees are freed.
    • Message 的构造和释放在堆栈上进行,涉及到动态内存的生成和释放,这一步骤非常昂贵。

查看 version

protoc --version

Python

Enum

Could not serialize object: TypeError: can’t pickle google.protobuf.pyext._message.EnumDescriptor objects

我在实际 spark 上处理数据时,报错 “Could not serialize object: TypeError: can’t pickle google.protobuf.pyext._message.EnumDescriptor objects”, 通过报错信息,很明确这是在实际 python 代码中引用 enum 导致的问题.

enum_test.protoview raw
1
# Add code later

参考教程

[toc]

std::reverse

  • Reverses the order of the elements in the range [first,last).

Demo

全部反转_demo++view raw
1
2
void Method2_erase() {
vector<int> data = ConstructVector();
部分反转_demo++view raw
1
// 再次打印更新后 vector 容器的大小和容量

源码

源码下载

源码下载

编译

1
2
cd 文件下载目录
g++ vector_reverse.cpp -o test --std=c++14

[toc]

clear

  • A reallocation is not guaranteed to happen, and the vector capacity is not guaranteed to change due to calling this function.

测试

clear demo++view raw
1
2
3
4
5
6
7
8
9
10
11
12
void Method1_clear() {
vector<int> data = ConstructVector();
// 打印 vector 容器的大小和容量
std::cout << "original: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;

data.clear();

// 再次打印更新后 vector 容器的大小和容量
std::cout << "new: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;
}

输出

1
2
3
Method 1
original: size = 5 ; capacity = 5
new: size = 0 ; capacity = 5

erase

  • Removes from the vector either a single element (position) or a range of elements ([first,last)).

  • An iterator pointing to the new location of the element that followed the last element erased by the function call.

测试

erase demo++view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
void Method2_erase() {
vector<int> data = ConstructVector();
// 打印 vector 容器的大小和容量
std::cout << "original: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;

for (auto iter = data.begin(); iter != data.end();) {
iter = data.erase(iter);
}

// 再次打印更新后 vector 容器的大小和容量
std::cout << "new: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;

vector<int> data1 = ConstructVector();
data1.erase(data1.begin(), data1.begin() + 2);

std::cout << "new: size = " << data1.size()
<< " ; capacity = " << data1.capacity() << std::endl;
}

输出

1
2
3
4
Method 2
original: size = 5 ; capacity = 5
new: size = 0 ; capacity = 5
new: size = 3 ; capacity = 5

swap

  • Exchanges the content of the container by the content of x, which is another vector object of the same type. Sizes may differ.

  • After the call to this member function, the elements in this container are those which were in x before the call, and the elements of x are those which were in this. All iterators, references and pointers remain valid for the swapped objects.

测试

erase demo++view raw
1
2
3
4
5
6
7
8
9
10
11
12
void Method3_swap() {
vector<int> data = ConstructVector();
// 打印 vector 容器的大小和容量
std::cout << "original: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;

vector<int>().swap(data);

// 再次打印更新后 vector 容器的大小和容量
std::cout << "new: size = " << data.size()
<< " ; capacity = " << data.capacity() << std::endl;
}

输出

1
2
3
Method 3
original: size = 5 ; capacity = 5
new: size = 0 ; capacity = 0

区别

  • vector 内存占用空间只会增长,不会减小。比如你首先分配了 10,000 个字节,然后 erase 掉后面 9,999 个,则虽然有效元素只有一个,但是内存占用仍为 10,000 个。所有空间在 vector 析构时回收。
  • 如果想清空原来数据占用的空间,我们可以通过交换技术 swap, 就是通过交换函数 swap (),使得 vector 离开其自身的作用域,从而强制释放 vector 所占的内存空间.

源码

源码下载

源码下载

编译

1
2
cd 文件下载目录
g++ vector_clear.cpp -o test --std=c++14

Reference

周五晚上从北京乘火车出发,第二天早晨到达大连火车站;在大连游玩三天,第三天晚上乘高铁返回北京,游览了大连知名的星海广场、海之韵公园,棒棰岛等景点,品尝了炒闷子等美食,还能在市区近距离喂野生鹿,非常开心的旅行。

Read more »

在工作和生活中,我们经常需要在外部访问我们家中的主机。然而,由于主机处于内网中,外部设备 (公网) 很难直接连接到主机以获取所需的资料。

本文将介绍一种通过内网穿透软件来搭建内网服务的方法,使得外部用户能够方便地访问和使用内网中的服务和资源。在这个过程中,将会涉及到内网穿透和反向代理的核心技术。

通过调研不同的 内网穿透工具,目前主要分为两种类型:

  • 一种是通过销售硬件设备和流量的方式实现,比如快解析、花生壳、神卓互联、NAT123 等。这些工具拥有自主研发的核心技术,可以在淘宝等平台直接购买和配置。然而,这种方式的缺点是需要付费购买硬件设备,并且免费流量有限制,适合一些专业用户或氪金用户。

  • 一种是使用免费开源软件(如 frp 和 nps)来搭建内网穿透,不需要额外购买硬件设备,但需要具备公网 IP 的条件。这种方式的优点在于可以根据自己的需求进行定制化配置,后续扩展性强,但对于新手来说入门门槛较高。

考虑到使用开源软件的优点,我的本地主机没有敏感信息,流量不设限制,所以我选择了免费开源软件 – frp 来搭建内网穿透服务。请注意,虽然 frp 目前使用广泛,但是本身逻辑设计有先天性缺陷,网络安全性差,非常容易造成网络堵塞,不能长时间连接使用,技术不够成熟.

我的应用场景

  • 在办公室或外出办公时,能够通过远程 ssh 控制家中的另一台电脑;
  • 家中电脑上运行了一个 web 服务,希望能够让非局域网的用户访问到这个服务。

工具和材料

  • 一个云服务器(包含公网 IP);
  • 本地电脑需要联网;
  • 一个域名(用于多个 web 服务,如果只有 ssh 访问则不需要)。

请注意,以下的教程适合具备一定计算机基础的开发者,对于新手来说可能存在一定的配置难度。

我的网络配置示意图

我进行了如下的网络配置,以实现通过 frp 在远程访问家中的主机和使用 web 服务的目标。比如,在 ipad 上就可以通过网页连接内网服务上的 stable diffusion 生成图片。具体示意图如下:

frp 是什么?

frp 是一个专注于内网穿透的高性能的反向代理应用,支持 TCP、UDP、HTTP、HTTPS 等多种协议,且支持 P2P 通信。可以将内网服务以安全、便捷的方式通过具有公网 IP 节点的中转暴露到公网。

内网穿透是什么?

内网穿透,即 NAT(Network Address Translator)穿透,是指计算机在内网(局域网)内使用私有 IP 地址,在连接外网(互联网)时使用全局 IP 地址的技术。简而言之,内网穿透可以将内网中的服务暴露到公网,使得这些服务可以通过公网访问。

反向代理是什么?

反向代理(reverse proxy)是指以代理服务器来接受 internet 上的连接请求,然后将请求转发给内部网络上的服务器,并将从服务器上得到的结果返回给 internet 上请求连接的客户端,此时代理服务器对外就表现为一个反向代理服务器。

frp 安装

你可以参考 安装教程 中的详细步骤来下载、部署和配置 frp。该教程提供了安装和开机自启动的指导,具有很好的实用性。

我的配置环境

frp 服务端:

操作系统:Ubuntu 20.04

frp 客户端设备 #1:

操作系统:Ubuntu 20.04

frp 客户端设备 #2:

操作系统:Ubuntu 22.04

如何设置 frp 支持多个本地网页终端

在我本地的开发机器 #2 ,部署了 stable diffusion 和 Jupyter Notebook 两个 web 应用,它们通过指定的本地端口提供服务,例如通过 127.0.0.1:8080 可以访问 jupyter。由于这些应用都部署在本地,无法直接从公网访问,因此 #2 主机需要配置 frpc 服务来支持公网访问。

多 web 服务主机配置

在 #2 的 frp 的配置文件(frpc.ini)添加下面的内容

[frpc.ini]
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18

[common]
server_addr = 1.2.3.4 # 替换成公网 IP
server_port = 1234 # 替换成开放的 Port
# 此处省去 token 等配置

[web1] # 此处配置用于远程访问内网电脑上的 A 服务
type = http
local_ip = 127.0.0.1
local_port = port1
custom_domains = a.my_domain.com

[web2] # 此处配置用于远程访问内网电脑上的 B 服务
type = http
local_ip = 127.0.0.1
local_port = port2
custom_domains = b.my_domain.com

在上述配置中,我们使用不同的 custom_domains(例如 a.my_domain.com 和 b.my_domain.com)以及不同的 local_port(例如 8888 和 9999)来区分两个本地网页终端。在实际应用中,通过 custom_domains:vhost_http_port 就可以访问内网的 web 项目.

VPS 服务器配置

在 frp 服务器上配置相应的转发规则,将请求转发到本地网页终端。你可以在 frps.ini 配置文件中进行设置。

[frps.ini]
1
2
3
4
5
6
7
8
[common]
bind_port = 1234
token = xxxx
vhost_http_port = 8888
dashboard_port = xxxx
dashboard_user = xxxx
dashboard_pwd = xxxx

如何在服务器上静默启动

nohup 命令在用户注销后继续运行命令
1
2
# 将 frps 放到后台运行
nohup ./frps -c frps.ini &

通过以上配置,你可以通过 a.my_domain.com:8888 访问第一个本地网页终端,通过 b.my_domain.com:8888 访问第二个本地网页终端。

frp 如何支持多个客户端

如果你想要支持多个客户端,需要在每个客户端安装一个 frpc 服务,并根据每个设备的差异进行配置,确保每个设备的 remote_port 不重复即可。

上文提到,本地有两台主机,如果想让两台主机都可以远程访问,需要在每个客户端安装一个 frpc 服务.

设备 #1

[frpc.ini]
1
2
3
4
5
6
7
8
9
10
11
12

[common]
server_addr = 1.2.3.4 # 替换成公网 IP
server_port = 1234 # 替换成开放的 Port
# 此处省去 token 等配置

[ssh1] # 若有多个客户端,名称不要重复。
type = tcp
local_ip = 127.0.0.1
local_port = 22
remote_port = 2345 # 远程连接端口不要重复

设备 #2

[frpc.ini]
1
2
3
4
5
6
7
8
9
10
11
12
13
14

[common]
server_addr = 1.2.3.4 # 替换成公网 IP
server_port = 1234 # 替换成开放的 Port
# 此处省去 token 等配置

[ssh2] # 若有多个客户端,名称不要重复。
type = tcp
local_ip = 127.0.0.1
local_port = 22
remote_port = 3456 # 远程连接端口不要重复

# 此处省去 web 等配置

VPS 服务器配置

[frps.ini]
1
2
3
4
5
6
7
8
[common]
bind_port = 1234
token = xxxx
vhost_http_port = 8080
dashboard_port = xxxx
dashboard_user = xxxx
dashboard_pwd = xxxx

根据提供的示例,两台机器都绑定服务器的 1234 端口,但是远程连接的端口不同,第一台机器的远程连接端口为 2345,第二台机器的远程连接端口为 3456。假设 #1 用户名为 test1, #2 用户名为 test2, 那么

[#1 机器连接]
1
ssh  -oPort=2345 test1@1.2.3.4
[#2 机器连接]
1
ssh  -oPort=3456 test2@1.2.3.4

安全性

Ipad 等移动设备如何连接内网机器

  • iPad 安装第三方 ssh 工作,我是用的是 termius,免费的基本服务就满足需求
  • iPad 通过 termius 登陆公网 VPS
  • 在公网 VPS 上通过上述 frp 命令可以直接连接内网机器

iPad 为什么需要安装第三方软件

SSH(Secure Shell Protocol,安全外壳协议)是一种用于加密网络传输的协议,使用户能够在网络中建立 SSH 客户端和服务器之间的安全连接。目前,SSH 最常用于远程登录系统。在类 Unix 系统(如 Linux 和 macOS)中,SSH 基本上是自带的功能,而 Windows 系统也逐渐支持这一协议。然而,在移动设备上,用户仍需要借助第三方软件进行 SSH 操作。

参考资料

0%